
Modernisez votre stack data avec DBT : moins de dette technique, plus de vitesse pour décider

Je travaille avec DBT (Data Build Tool) depuis plusieurs mois, et c’est devenu fondamental dans de nombreux processus de données pour beaucoup de nos clients, au point d’être carrément un standard de l’industrie.
C’est un outil open source qui, adossé à des moteurs de bases de données comme Postgres, Databricks, Snowflake ou Redshift, permet de transformer les données de manière flexible et efficace. Pour l’essentiel, DBT facilite l’écriture de transformations basées sur SQL, mais avec des couches de fonctionnalités supplémentaires qui les rendent plus maintenables, testables et fiables.
Mais d’abord, quelques mots sur le plan personnel
Ma formation dans le monde de la donnée a commencé côté data science et développement de modèles de machine learning. Comme je ne viens pas d’un parcours traditionnel en informatique ou en mathématiques, à mes débuts j’ai dû me concentrer sur un seul aspect pour essayer d’améliorer mes compétences et trouver une opportunité professionnelle.
Heureusement, cette opportunité s’est présentée et au fil des années j’ai énormément grandi en tant que professionnel, jusqu’à arriver chez deployr. Mais il y a une réalité incontournable : au cours de ces années, les rôles techniques orientés ML/IA et programmation ont changé de manière significative pour plusieurs raisons :
- L’arrivée de ChatGPT et d’autres outils d’IA qui accélèrent le développement de code,
- L’émergence de frameworks qui abstraient une grande partie du travail qu’il fallait faire à la main,
- La popularisation de la formation en ligne à distance,
et bien d’autres facteurs ont fait que la barrière d’entrée à cette industrie a baissé significativement, et en parallèle, nous sommes devenus plus productifs, avec plus de temps disponible pour différentes tâches.
Cela veut dire que dans beaucoup de cas le rôle du data scientist traditionnel est tombé en désuétude et d’autres figures l’ont remplacé, pas forcément dans les fonctions mais dans la portée et la diversité des responsabilités. Chez deployr, on a décidé d’appeler ce rôle « Data Developer » et c’est celui avec lequel je m’identifie le plus aujourd’hui : je ne me concentre plus à 100 % sur le développement d’un modèle de machine learning, mais je participe à tout le processus de données de bout en bout.
Toutefois, pour pouvoir faire cela, j’ai dû me former en Data Engineering et m’adapter à l’époque. Avec le client avec lequel je travaille, après nous être concentrés sur le modélisation et le ML, il a fallu concentrer les efforts sur l’efficacité du processus de données et la modernisation de l’infrastructure. Et la technologie choisie pour cela a été un outil qui a changé ma conception d’un processus de données intégral et qui porte un nom digne d’une suite de Dragon Ball Z : DBT.
Qu’est-ce que DBT ?
Comme expliqué plus haut, DBT est un outil qui permet d’écrire des transformations basées sur SQL, avec beaucoup d’autres fonctionnalités. Mais à la différence des outils traditionnels d’ETL (Extract, Transform, Load), DBT se concentre exclusivement sur le T.
Cela signifie que DBT part du principe que les données sont déjà stockées dans un data warehouse et nous fournit les outils pour modifier et traiter ces données à l’intérieur même du warehouse en information prête à être consommée par d’autres processus, comme des tableaux de bord BI ou des modèles de machine learning.
Le concept fondamental de DBT est de traiter les transformations de données comme une forme de développement logiciel. Cela amène les bonnes pratiques de l’ingénierie logicielle au travail avec les données, incluant le contrôle de versions, la modularité, les tests, la documentation et la gestion du déploiement.
Pourquoi choisir DBT ?
Du point de vue des développeurs, la facilité d’implémentation et le côté structuré des projets font de DBT un framework de travail très agile et productif.
Mais d’un point de vue métier, au moment de choisir le stack avec lequel on va commencer à travailler – ou d’évaluer des alternatives de remplacement/amélioration de l’existant –, DBT a plusieurs points très forts en sa faveur :
- Efficacité des coûts : DBT aide à tirer parti efficacement des ressources de calcul et de leurs coûts associés grâce à l’optimisation des requêtes, l’implémentation de modèles incrémentaux, les transformations planifiées et la réutilisabilité du code, entre autres.
- Vitesse de développement accrue : DBT facilite l’accélération des cycles de développement des processus de données et leur analyse ultérieure, ce qui se traduit par des insights plus rapides pour soutenir les décisions métier.
- Réduction de la dette technique : l’approche structurée de transformation des données évite le code désordonné et les processus non documentés, ce qui réduit les coûts à long terme en évitant la duplication du travail ou la réécriture de scripts.
- Améliorations de la gouvernance des données : la documentation, le suivi de lignage et les tests inclus dans le framework soutiennent le respect des exigences de compliance et de gouvernance.
- Scalabilité : la capacité à grandir avec les équipes data et à scaler en parallèle avec les besoins de l’entreprise est un grand atout de DBT.
- Démocratisation de l’accès aux données : l’approche basée sur la transparence et la documentation aide à ce que les décisions métier soient data-driven.
De plus, comme il s’intègre avec la majorité des moteurs de bases de données et des fournisseurs de data warehousing, la barrière d’entrée à l’implémentation de DBT est comparativement très basse. D’après notre expérience, toute entreprise qui pense à moderniser son infrastructure de données doit au minimum le considérer comme une option.
Concepts centraux
DBT s’appuie sur une série de piliers fondamentaux pour exploiter toutes les capacités techniques du framework. Dans les prochains articles de cette série, on va approfondir chacun de ces composants et voir des exemples concrets d’application. Pour l’instant, commençons par les bases.
Modèles
Les modèles sont les briques fondatrices de tout processus de transformation dans DBT. Ce sont des scripts SQL qui contiennent un SELECT statement et qui définissent les transformations des données, ce qui résulte en un dataset, et correspondent normalement à une table ou à une vue dans le data warehouse.
Voyons un exemple de modèle super simple dans DBT.
Analysons brièvement ses composants :
-
{{ config(materialized=‘table’) }}
: c’est une syntaxe propre à DBT qui indique l’utilisation d’une macro dont la fonction est de matérialiser (persister) cette transformation comme une table et de stocker les résultats de notre requête dans la base de données. Pas de panique, on verra ce que sont les macros et leur syntaxe. - SELECT statement : il constitue le noyau de la logique de transformation d’un modèle. Il définit comment sont extraites, transformées et structurées les données des tables source ou d’autres modèles DBT.
-
{{ ref(‘stg_customers’) }}
: c’est une autre macro qui référence un modèle différent à l’intérieur de notre processus DBT, dans ce cas une version compilée d’une table appelée ‘stg_customers’. Cela garantit la gestion des dépendances pour que DBT exécute ‘stg_customers’ avant d’exécuter le modèle actuel.
Dans les prochains articles, on verra différents types de transformations qu’on peut réaliser avec nos modèles.
Sources
Les sources sont des fichiers YAML qui définissent les données upstream sur lesquelles les modèles sont construits, typiquement les données brutes chargées dans le data warehouse. Autrement dit, ils servent à enregistrer et paramétrer les sources de données qui vont ensuite alimenter les différents processus DBT.
Voyons un exemple de fichier source :
Matérialisations
DBT supporte différents types de persistance des données qu’on transforme dans notre processus.
- Table : une table complète qui se reconstruit à chaque exécution du processus.
- Vue : une vue SQL qui interroge des tables sous-jacentes.
- Incrémental : ne traite que les enregistrements nouveaux ou modifiés.
- Éphémères : utilisées comme sous-requêtes dans d’autres modèles sans les persister.
- Snapshots : matérialisations spéciales qui enregistrent les changements historiques des données au fil du temps.
Dans les prochains articles de la série, on utilisera plusieurs de ces matérialisations pour analyser leurs différents effets sur le processus.
Macros
Les macros sont des sections de code SQL réutilisables, similaires aux fonctions dans d’autres langages de programmation, qui servent à éviter la redondance. Elles peuvent accepter des paramètres, des conditionnelles et des boucles, et sont capables de retourner du code SQL à insérer dans les modèles. DBT fournit des macros intégrées pour les opérations courantes, et on peut importer d’autres packages DBT pour étendre leur fonctionnalité ou même développer nos propres macros – un peu comme faire une fonction en Python.
Seeds
Les seeds sont des fichiers CSV qui peuvent être chargés directement dans le data warehouse, ce qui les rend utiles pour les données de référence statiques qui ne changent pas fréquemment. Par exemple, si on a une table auxiliaire qui contient de l’information qu’on utilise dans nos processus de transformation et qui ne subira normalement pas de modifications, on la définira habituellement comme un seed.
Snapshots
Les snapshots sont un type spécial de modèle qui enregistre les changements dans les données au fil du temps. Ils conservent l’historique des modifications des données grâce à l’ajout de colonnes de métadonnées qui permettent un suivi. Les snapshots sont particulièrement utiles pour des entités qui changent lentement mais dont le suivi historique est important, comme l’information sur les clients ou les détails des produits.
Fichiers de configuration
Ce fichier .yml est indispensable pour tout projet et sert de centre de contrôle du projet, en définissant tout, des conventions de nommage jusqu’aux stratégies de matérialisation. Chaque fichier de projet doit inclure certains champs obligatoires, comme on le voit dans l’exemple suivant :
Il existe des configurations avancées supplémentaires, qui vont du comportement des snapshots à la configuration des tests en passant par les définitions de variables. On en verra quelques-unes dans les prochains articles quand on utilisera les différents composants de DBT, mais pour l’instant vous pouvez consulter la documentation officielle de DBT pour le yml de configuration si vous voulez plus d’information à ce sujet.
dbt Core vs dbt Cloud
dbt Core est un outil en ligne de commande open source gratuit, mais il requiert un hébergement propre et la gestion manuelle de l’infrastructure. Il n’a pas de scheduler intégré et dépend d’outils externes comme Airflow pour l’automatiser. De plus, comme il n’a pas d’interface graphique et a des capacités de logging limitées, le contrôle de versions et la configuration CI/CD doivent être gérés manuellement, ce qui est un peu fastidieux et demande des connaissances techniques.
En revanche, dbt Cloud est une plateforme SaaS commerciale avec des coûts associés (même s’il y a un tier gratuit), entièrement gérée par dbt Labs, l’entreprise créatrice de DBT. Elle fournit un IDE web pour développer les processus, un scheduler de jobs intégré, du logging et du monitoring avancés, et des workflows CI/CD automatisés. De plus, elle fournit un hébergement intégré de la documentation, des outils de collaboration en équipe et un contrôle d’accès basé sur les rôles. Enfin, étant un produit payant, elle a des options de support dédiées.
Dans cette série d’articles, on utilisera DBT Core pour pouvoir développer nos transformations localement, mais selon les besoins d’un business, le budget disponible et les particularités du projet, DBT Cloud peut être une excellente option. Il est même possible d’utiliser DBT Core puis de se connecter à DBT Cloud, ce qui permet de développer localement mais de productiviser dans la version en ligne !
Demo time !
Pour clôturer cet article et ceux qui viennent dans les prochaines semaines, j’aimerais vous laisser du code de pratique où on verra une implémentation d’un projet très simple dans dbt. Cette semaine, on va créer l’environnement virtuel, installer DBT Core et construire le répertoire du projet via l’exécution d’une simple commande. Dans les prochaines livraisons, on verra comment créer des intermédiaires et des source files, et comment utiliser des macros, des seeds et générer de la documentation, entre autres.
Avant toute chose, on ouvre une nouvelle fenêtre dans VSCode. J’avais préalablement créé un dossier appelé dbt-demo pour y héberger notre projet de test. Ensuite, comme c’est une pratique courante et recommandée, on monte notre environnement virtuel et on l’active. Dans mon cas, comme je travaille sous Linux, ça ressemble à ça :
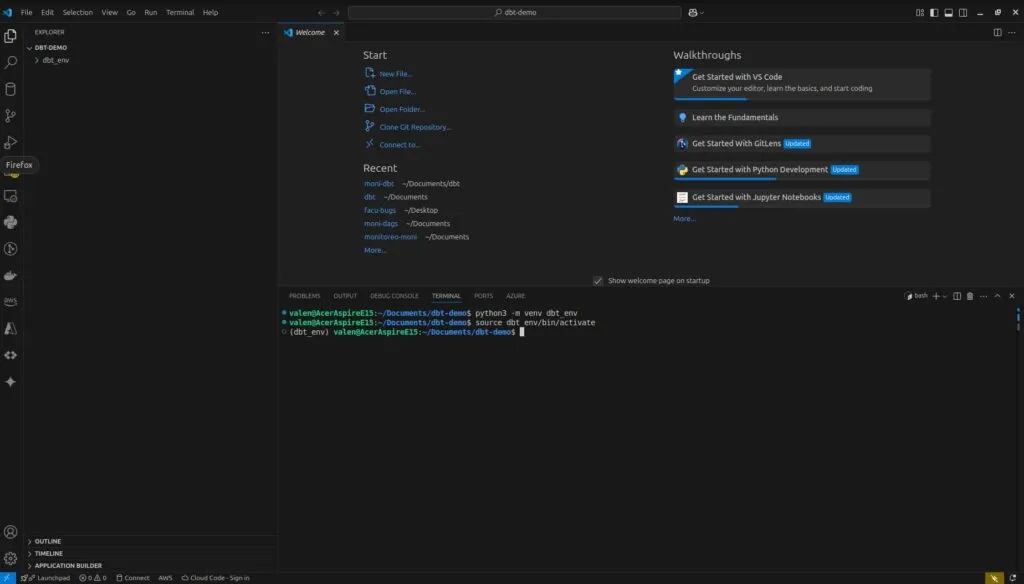
Ensuite, on installe DBT Core, et une fois terminé, on monte le setup initial.
pip install dbt-core
dbt init my_project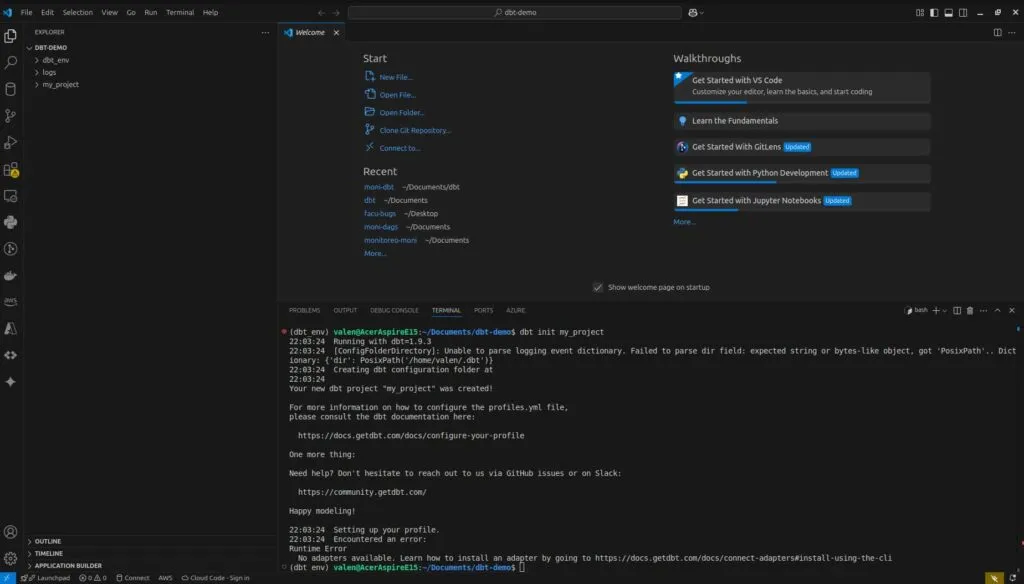
Vous remarquerez que le processus se termine par une runtime error. C’est parce qu’on n’a installé aucun adaptateur de moteur de base de données. Voici quelques exemples qu’on peut utiliser :
- Databricks : pip install dbt-databricks
- PostgreSQL : pip install dbt-postgres
- BigQuery : pip install dbt-bigquery
- Snowflake : pip install dbt-snowflake
- Redshift : pip install dbt-redshift
On installera celui de Postgres pour ce tutoriel. Pour l’instant, regardons en détail quels composants DBT a créés dans notre répertoire :
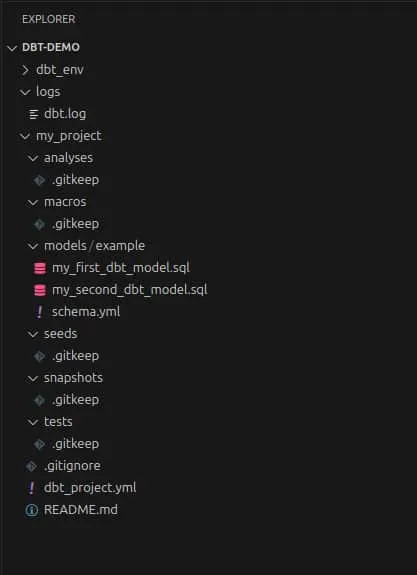
On peut y voir notre environnement virtuel, un dossier avec des logs et un dossier principal appelé my_project (comme on a nommé ce projet de test quand on a lancé la commande dbt init my_project). Pour l’instant les dossiers analyses, macros, seeds, snapshots et tests sont vides à l’exception des fichiers .gitkeep. On les utilisera dans les prochains articles.
Maintenant on se concentrera sur seulement deux composants : models et dbt_project.yml.
Dans dbt_project.yml, DBT nous a déjà créé une version initiale du fichier de projet pour qu’on puisse le personnaliser selon nos besoins :
Maintenant on va créer profiles.yml dans le dossier du projet et coller le texte indiqué ci-dessous :
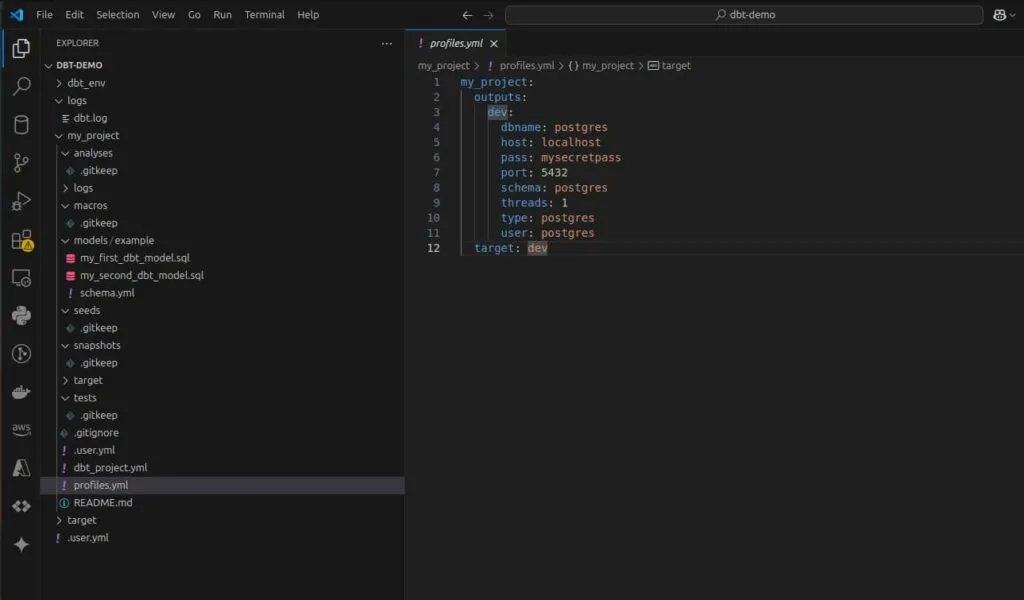
Ce fichier ne se commit jamais, c’est pour ça qu’on ne le met pas directement dans le projet mais dans un répertoire sécurisé. Mais vu que c’est un tutoriel de test, on va pour l’instant le laisser ici et ajouter ce fichier au .gitignore comme bonne pratique pour garantir qu’on ne pushera jamais d’information sensible sur notre repository GitHub.
On y verra que DBT a déjà préconfiguré certains fichiers qui ne doivent pas non plus être inclus dans le repo, donc on ajoute profiles.yml à cette liste.
Étape suivante, on va installer l’adaptateur Postgres pour DBT, avec la commande
pip install dbt-postgresCela installera et mettra à jour les composants nécessaires pour exécuter une base de données Postgres, qu’on utilisera plus en profondeur dans les tutoriels futurs mais qui nous servira dans cette première étape à exécuter nos modèles prédéfinis.
Une fois l’adaptateur Postgres installé, on va lancer Docker avec la commande suivante (uniquement par commodité, on pourrait utiliser n’importe quelle instance Postgres qu’on veut), qui correspond à la configuration qu’on a définie dans notre fichier profiles.yml :
docker run --name dbt_postgres -e POSTGRES_PASSWORD=mysecretpass -p 5432:5432 -d postgresEnsuite on ira dans le répertoire du projet, où on exécutera bientôt nos transformations : on tape cd my_project dans la console pour se positionner dans le bon dossier. Maintenant tout est prêt pour lancer le projet.
Mais avant, l’autre composant qu’on va observer aujourd’hui est le dossier models, qui contient un autre dossier examples, où on hébergera toutes les transformations que mènera notre projet. À l’intérieur du dossier examples, inspectons les deux modèles d’exemple que DBT a créés.
Ce sont deux processus extrêmement simples et sans aucune complexité, dont le seul objectif est de montrer comment s’écrivent les transformations et comment s’enchaînent les modèles.
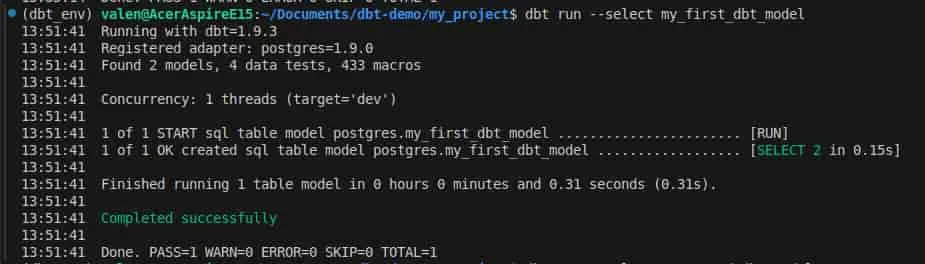
Maintenant oui, ce que tout le monde attendait : on va exécuter les transformations que ces fichiers de modèle stipulent. Tapez la commande suivante dans la console :
dbt run --select my_first_dbt_modelCette instruction a deux composants :
- dbt run : sert à exécuter les modèles DBT dans notre projet en lançant les transformations définies dans nos fichiers .sql.
- –select my_first_dbt_model : cela spécifie que le seul modèle qu’on veut lancer est celui qui s’appelle my_first_dbt_model au lieu de lancer tous les modèles du projet.
Cela devrait produire cet output dans la console, qui nous indique que le modèle a été exécuté avec succès :
Une petite variante : on peut faire la même chose en ajoutant un + à la fin de la première instruction donnée.
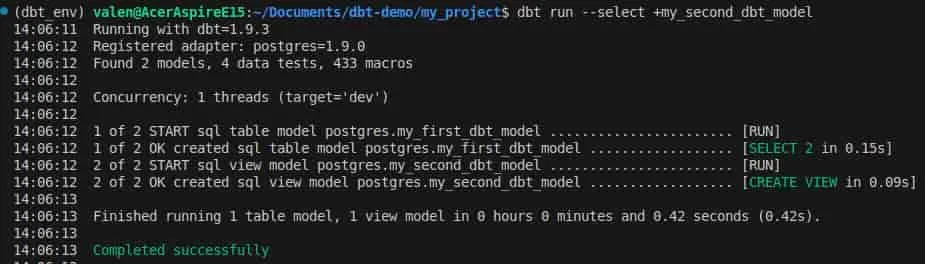
dbt run --select my_first_dbt_model+Cela exécute my_first_dbt_model et tous les modèles downstream, c’est-à-dire ceux qui dépendent de celui-ci. On peut faire la même chose mais à l’envers avec l’autre :
dbt run --select +my_second_dbt_modelAvec ça, on exécute my_second_dbt_model upstream, c’est-à-dire avec les modèles dont celui-ci dépend.
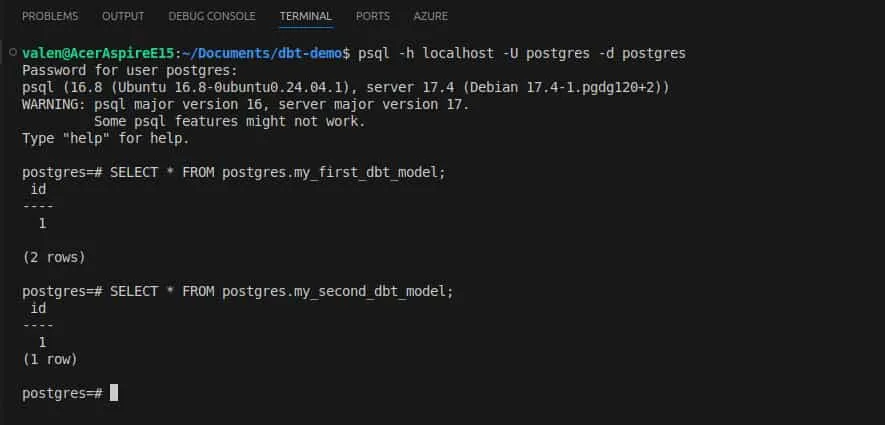
Pour finir, on va faire une requête simple. On va utiliser psql pour se connecter au Postgres qu’on a monté précédemment avec Docker. On vérifie le user et le pass selon ce qu’on a configuré dans profiles.yml puis on fait la requête :
Vous pouvez essayer de jouer avec les modèles d’exemple que fournit DBT pour ajouter plus de colonnes, réaliser des transformations supplémentaires et exécuter des requêtes qui visualisent les résultats. La meilleure manière d’apprendre, c’est de mettre les mains dans le cambouis !
Ce n’est pas un adieu, c’est un à bientôt
Avec ce tutoriel, on a déjà initialisé un projet DBT de zéro, créé les fichiers de configuration basiques, monté une base de données Postgres et lancé nos premiers modèles pour réaliser des transformations. Côté théorie, on s’est familiarisés avec les concepts basiques de ce framework.
Dans les prochains articles, on approfondira le concept de modèles et ses différentes variantes, on populera une base de données dummy pour tester des transformations, on créera un seed comme table auxiliaire, on utilisera des macros pour abstraire du code redondant et on générera de la documentation automatique.
Une des choses que j’aime le plus dans le fait de travailler chez Deployr, c’est qu’on partage ce qu’on sait. Chaque projet, chaque client et chaque défi est un apprentissage pour nous, et démocratiser la connaissance compte quand on appartient à une communauté comme celle des gens qui travaillent dans la donnée. On se voit à la prochaine édition.


