Blog
Idées et opinions sur les données, l'IA et la technologie appliquée.
Combien coûte un projet data avec un cabinet de conseil ? Variables, fourchettes et ce qu'on ne vous dit jamais
Guide complet pour comprendre le coût d'un projet data en environnement de production, et les variables à prendre en compte pour savoir d'où vient le coût de l'investissement.
La différence entre une PoC et un MVP (et pourquoi les confondre coûte cher)
La plupart des projets IA échouent parce qu'il n'y a pas de conversation claire sur la nécessité de prouver que quelque chose peut être fait ou qu'il fonctionne réellement en production. Voici comment éviter cette erreur.
Pourquoi la majorité des projets d'IA n'aboutissent à rien
La plupart des projets d'IA n'échouent pas techniquement. Ils n'arrivent jamais en production. Voici quatre erreurs qu'on voit revenir sans cesse, et ce que les projets qui réussissent ont en commun.
DBT en action : construire la couche de marts qui connecte vos données au business
Les marts sont la couche où vos modèles DBT deviennent vraiment utiles : des datasets curés, prêts pour l'analyse et les décisions métier.
Comment utiliser des conteneurs custom dans SageMaker pour l'inférence avec LightGBM (guide pas à pas)
Guide complet pour exécuter des inférences batch avec LightGBM sur AWS SageMaker : apprenez à déployer du traitement massif, reproductible et scalable avec des conteneurs et de l'IA predictive.
Vibe coding avec l'IA : 10 bonnes pratiques pour coder vite (sans perdre le contrôle)
Le vibe coding, ce n'est pas tout déléguer à l'IA : c'est programmer avec assistance et discernement. Dans ce guide, on vous montre 10 pratiques pour documenter en langage naturel, générer des tests, appliquer des changements incrémentaux, modulariser, choisir les bons outils et versionner sans stress.
Modèles, Sources et Seeds dans dbt : tutoriel complet pour transformer les données avec du SQL reproductible
Maîtrisez dbt avec ce guide pratique : apprenez à créer des modèles, déclarer des sources et gérer des seeds avec Docker et Postgres. Tutoriel pas à pas pour accélérer votre modern data stack et obtenir des transformations de données reproductibles et fiables.
Pétrole & gaz 4.0 : les clés du secteur pour appliquer l'IA
La transformation numérique dans le pétrole et le gaz promet des gains d'efficacité, de sécurité et de coûts, mais la culture d'entreprise peut freiner l'avancée. Résistance au changement, déficits de talents numériques et hiérarchies rigides font que 70 % des projets stagnent.
Comment ajouter une IA générative locale à Grafana et transformer vos graphiques en décisions
Intégrez un modèle de langage local (LLM) dans Grafana et transformez vos dashboards en outils intelligents pour la prise de décision. Dans ce guide pas à pas, on vous montre comment visualiser, analyser et interpréter des métriques en temps réel sans exposer vos données à des services externes.
IA et Ressources Humaines : 6 façons d'automatiser et booster votre entreprise
L'intelligence artificielle générative (GenAI) est en train de redéfinir le domaine des Ressources Humaines. Cet article explore comment l'IA appliquée peut optimiser six processus clés : acquisition de talents, relation avec les collaborateurs, formation, gestion de la performance, administration et compliance.
Coder avec les type hints : une pratique simple qui optimise votre business
Découvrez comment l'utilisation des type hints en Python et d'outils comme MyPy peut vous aider à écrire un meilleur code, éviter les erreurs et améliorer l'efficacité de votre équipe de développement. Des bonnes pratiques simples, avec un impact réel sur votre business.
La vérité qui dérange sur l'IA : et si ce n'était pas pour votre entreprise ?
Beaucoup d'entreprises pensent qu'elles doivent adopter l'intelligence artificielle, mais ce n'est pas toujours la bonne décision. Dans cet article, on vous aide à identifier si votre entreprise est vraiment prête à tirer parti de l'IA, comment éviter des investissements mal ciblés, et pourquoi la stratégie de données reste le véritable facteur différenciant.
Modernisez votre stack data avec DBT : moins de dette technique, plus de vitesse pour décider
DBT optimise vos processus de données pour générer des insights plus rapidement, réduire la dette technique et améliorer le retour sur investissement analytique.
Data science et pétrole : une opportunité unique pour l'Argentine
Dans le contexte argentin, le secteur oil & gas présente une opportunité stratégique unique. Découvrez comment mettre en œuvre des solutions de data science pour booster l'efficacité et la rentabilité.
Discovery Machine Learning : 4 semaines pour décider comment appliquer le ML à votre business
Chez Deployr, on a conçu un processus de Discovery en 4 semaines pour valider si le machine learning est la bonne solution pour votre problème métier. On vous explique comment ça marche et pourquoi c'est essentiel avant d'investir dans un projet de ML.
Une introduction aux outils de Data Quality en Python
Guide complet sur Great Expectations et PyDeequ : des outils de qualité des données en Python pour des pipelines ETL robustes et fiables.
Entrez dans le monde serverless en créant un scraper automatique de Twitter sur AWS en cinq étapes simples
Tutoriel pas à pas pour créer un scraper serverless avec Lambda, EventBridge et S3 : apprenez à automatiser l'extraction de données sans gérer de serveurs.
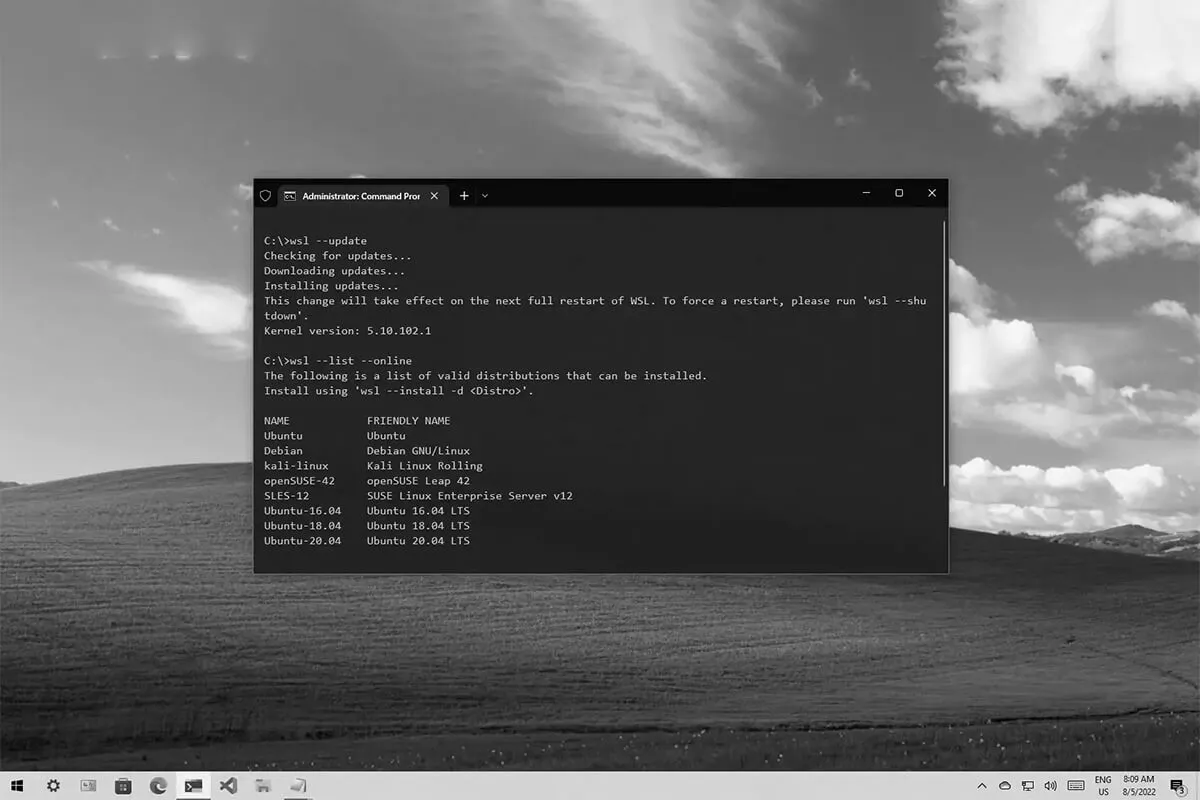
WSL : comment installer Linux dans Windows (le meilleur des deux mondes)
Le Windows Subsystem for Linux (WSL) permet aux développeurs d'utiliser un environnement GNU/Linux directement sur Windows. Une alternative simple et efficace au dual boot.
Rôles, permissions, identités et groupes : comment utiliser AWS en toute sécurité et sans avoir peur de se tromper ?
Guide complet pour comprendre et configurer le contrôle d'accès dans AWS : apprenez à créer des utilisateurs, des groupes, des rôles et des politiques de sécurité de manière propre et scalable.
Comment appliquer le Feature Selection dans votre projet de Data Science
Découvrez tout sur le feature selection, une technique de feature engineering utilisée pour sélectionner les caractéristiques les plus pertinentes pour un modèle de machine learning.
Vous avez un vrai problème technique ?
On ne vend pas de solutions génériques. Parlons de ce que vous devez résoudre.
Parlons-en