
Modèles, Sources et Seeds dans dbt : tutoriel complet pour transformer les données avec du SQL reproductible

Bienvenue dans la deuxième partie de cette série d’articles sur DBT. Dans la première livraison, on a fait une introduction générale à ce framework de transformation de données, on a vu ses concepts généraux, les composants d’un projet et on a lancé une série de commandes simples pour initialiser notre premier processus de transformation de données. Si vous ne l’avez pas lue, vous pouvez la consulter ici.
On va approfondir plusieurs des concepts déjà mentionnés, avec l’objectif de les comprendre à fond et de tirer parti des capacités complètes de l’outil. On va parler de modèles, sources de données et seeds, et continuer à professionnaliser notre projet de test.
Modèles
C’est le cœur de notre projet. Dans DBT, un modèle est simplement un fichier SQL qui contient une déclaration SELECT, ni plus, ni moins. Bien que cela sonne assez simple, en coulisse les modèles fonctionnent comme des abstractions qui nous permettent de créer des logiques de transformation modulaires, maintenables, avec contrôle de versioning et testables pour notre data warehouse. Voyons plus en détail ce qu’ils sont et comment ils fonctionnent.
Qu’est-ce qu’un modèle, réellement ?
Un modèle est un fichier .sql situé dans le répertoire models/ de notre projet DBT. Chaque modèle représente typiquement une étape de transformation, comme peut l’être le nettoyage de données, le réglage du type d’une colonne, l’agrégation ou la synthèse de données, l’union de sources de données, ou une infinité d’autres options. Voyons un exemple simple de modèle :
Dans ce cas, on sélectionne les clients actifs et on fait référence au modèle raw_customers en utilisant la fonction ref() (qu’on verra bientôt plus en détail) pour indiquer d’où seront obtenues les données. Ici, on peut référencer des sources brutes de données comme des data warehouses ou on peut indiquer qu’il faut consommer les données d’un autre modèle. C’est ainsi que les transformations s’enchaînent. Ma référence à raw_customers aurait très bien pu être à un hypothétique int_select_customers, un .sql antérieur qui filtre les clients avec lesquels on veut travailler.
Quand on utilise la commande dbt run pour exécuter nos modèles, ceux-ci se compilent en SQL et s’exécutent dans notre data warehouse, ce qui a pour résultat une matérialisation généralement sous forme de vue ou de table (DBT supporte d’autres types de matérialisation mais ils sont beaucoup plus rares), selon la configuration. D’ailleurs, une fois exécuté, on peut inspecter le code compilé dans le répertoire target/compiled et on verra comment les abstractions comme le ref() se traduisent en code SQL pur et dur.
Maintenant, analysons les parties d’un modèle.
Logique SQL
Comme on l’a dit précédemment, le SELECT statement est le noyau du modèle. Il peut être aussi simple ou aussi complexe que nécessaire, avec des filtres, des joins, des sous-requêtes, des CTE… On a tout l’arsenal SQL à notre disposition.
La fonction ref()
Cette fonction est utilisée pour référencer un autre modèle et remplit plusieurs rôles :
- Elle indique à DBT qu’il existe une dépendance entre modèles.
- Elle résout le schema ou la table correcte lors de l’exécution.
- Elle aide DBT à construire un DAG (sigle qui signifie « directed acyclic graph ») des dépendances des modèles.
Quand dans notre exemple on utilise FROM {{ ref(‘raw_customers’) }}, DBT comprendra qu’il doit d’abord construire ‘raw_customers’ avant d’exécuter notre modèle actuel.
Configurations et settings du modèle
Les modèles dans DBT peuvent avoir des configurations spécifiques qui déterminent comment et où se matérialisent les résultats, comment sont nommées les tables résultantes, ou comment ils sont groupés pour des tâches automatisées, entre autres. Ces configurations se définissent au début du fichier .sql du modèle en utilisant le bloc {{ config(…) }} ou dans le fichier dbt_project.yml.
Voyons les paramètres les plus courants et leur utilité :
materialized
C’est probablement le setting le plus important, car il définit sous quelle forme se matérialise le résultat du modèle dans le data warehouse. Il peut prendre l’une des valeurs suivantes :
- view : le résultat du modèle est créé comme une vue et c’est l’option par défaut. Il n’occupe pas d’espace disque et reflète toujours des données actualisées, bien que cela puisse impliquer un coût de calcul supérieur lors d’une requête.
- table : le modèle se matérialise comme une table. Cela implique que les données sont persistées au moment de lancer dbt run. Idéal pour les transformations lourdes ou quand on a besoin d’optimiser le temps de requête.
- incremental : cette option permet d’actualiser seulement une partie des données à chaque exécution du modèle, au lieu de recréer toute la table. C’est utile pour gérer de gros volumes de données dans des pipelines de production.
- ephemeral : ne se matérialise pas dans le warehouse. Le modèle devient un CTE (Common Table Expression) à l’intérieur d’un autre modèle qui le consomme. C’est la meilleure option pour des étapes intermédiaires qu’on ne souhaite pas persister.
schema
Permet de surcharger le schema par défaut configuré dans le projet. Nous sert lorsqu’on veut segmenter nos modèles par environnements (comme par exemple dev, staging, prod) ou par processus spécifiques.
alias
Contrôle le nom final avec lequel sera créée la table ou vue dans le warehouse. Par défaut, DBT utilise le nom du fichier .sql comme nom de la table générée, mais avec alias on peut le changer si on souhaite le faire tout en maintenant une convention de nommage de fichiers dans notre processus de transformation.
tags
Permettent d’étiqueter les modèles pour les regrouper logiquement. Ces tags peuvent ensuite être utilisés pour exécuter uniquement une partie spécifique du projet avec des commandes comme dbt run –select tag:incrementales, ou pour de l’analyse et de la documentation.
Sources
Dans tout modèle DBT, la première étape est de consommer des données qui existent déjà dans notre système : bases de données transactionnelles, systèmes tiers, APIs ou toute source qu’on considère nécessaire ou appropriée. Dans le framework DBT, ces sources externes (c’est-à-dire les tables qui n’ont pas été générées par DBT, mais qui sont déjà présentes dans le data warehouse) se configurent comme sources.
Cela permet à DBT de savoir que ces données font partie de notre logique de transformation et nous permet d’utiliser des fonctionnalités comme les tests automatiques, la documentation centralisée, et une visualisation claire dans le DAG des dépendances.
Définition des sources
Les sources de données se définissent dans des fichiers .yml à l’intérieur du répertoire models/, typiquement dans des fichiers comme src_*.yml, bien qu’une nomenclature spécifique ne soit pas nécessaire et que ce puisse être n’importe quel nom. Là, on utilise une structure YAML pour laisser une trace de nos données externes.
Dans ce cas, on a les composants suivants :
- raw_db est un identifiant logique pour la base de données d’origine.
- schema définit le schéma dans le warehouse où se trouvent les tables réelles.
- tables est la liste des tables concrètes qu’on veut utiliser comme sources.
Implémentation des sources
Maintenant qu’on a les sources de données définies dans notre YAML et prêtes à être utilisées… comment les implémente-t-on effectivement dans notre modèle ? Ici vient la fonction source() à notre aide. Voyons un petit exemple :
Dans ces deux simples lignes de code, ce qu’on dit à DBT c’est : « Je veux consommer la table customers qui est dans le schema raw et qui fait partie de la source rawdb ». Autrement dit, comme avec la fonction _ref(), ici DBT abstrait via des fonctions une grande partie de ce qu’il fait en coulisse. Mais, à la différence de ref(), source() est utilisée pour référencer des données externes.
Utiliser source(), en plus, a une série de bénéfices au-delà d’utiliser directement le nom de la table dans le modèle :
- Traçabilité et documentation : DBT peut inclure ces données dans la documentation générée automatiquement avec la commande dbt docs generate (qu’on verra plus tard pour créer la documentation de notre projet).
- Tests : on peut appliquer des tests automatiques sur les tables externes (comme vérifier qu’elles n’aient pas de valeurs nulles, qu’elles aient une clé primaire valide, parmi beaucoup d’autres options).
- Contrôle des changements : si le schéma ou le nom de la table change, on n’a qu’à le modifier dans le fichier .yml et non dans tous les modèles.
- Visualisation du DAG : les sources apparaissent comme des nœuds dans le graphe de dépendances, ce qui facilite énormément la compréhension du flux complet.
Quelques configurations additionnelles
La dernière chose qu’on verra des sources aujourd’hui, ce sont deux configurations additionnelles assez simples mais utiles pour la définition de nos sources. Par exemple, on peut documenter aussi bien les sources que les tables :
Et on peut déclarer des tests qu’on veut implémenter sur nos tables source :
Cela nous permet de garantir que le customer_id est unique et n’est pas une valeur nulle. C’est une excellente pratique de définir de bons tests qui donnent de la robustesse à nos pipelines de transformation de données.
Seeds
Le dernier composant qu’on verra aujourd’hui, ce sont les seeds. Dans DBT, les seeds sont des fichiers CSV qui vivent à l’intérieur du projet et se chargent directement dans le data warehouse comme des tables. Ils fonctionnent comme de petites bases de données statiques : ils peuvent représenter des catalogues de référence, des listes de codes, des règles métier, des mappings, ou même des données de test. Autrement dit, ils sont particulièrement utiles quand on a un ensemble de données qui ne subira pas de modifications ou qui en subira de très contrôlées, comme une liste de pays d’opération d’une entreprise ou une liste restreinte de fournisseurs.
Cette fonctionnalité est particulièrement utile quand on veut incorporer des datasets simples ou contrôlés par l’équipe data, sans avoir à dépendre d’intégrations externes ou de processus d’ingestion complexes. On copie le CSV dans le dossier /seeds de notre répertoire, on lance la commande dbt seed et bam, on est prêt à consommer ces données.
La différence clé entre seeds et sources au moment d’utiliser les données, c’est que les seeds se référencent avec la fonction ref() qu’on a déjà vue, comme les modèles. Dans la démo, on verra un seed en action.
Demo time !
Maintenant qu’on a ces concepts plus en tête, on va continuer à avancer avec la démo qu’on a commencée l’édition passée. Avant toute chose, pour maintenir l’organisation du projet, éliminons le dossier my_project/models/example qu’a généré automatiquement DBT au démarrage du projet, et ensuite on va créer une base de données dummy pour avoir à notre disposition un peu de data qu’on puisse traiter et voir les résultats.
Pour relancer le conteneur Docker (sauf si vous avez attendu toutes ces semaines patiemment avec l’ordi allumé et le conteneur actif), on va exécuter ces commandes dans notre terminal pour activer l’environnement virtuel qu’on a créé la fois passée et le conteneur :
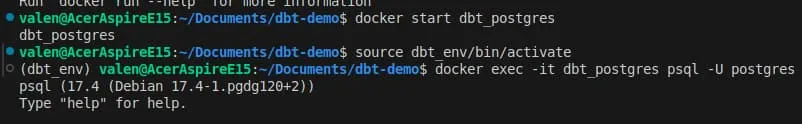
Démarrage du conteneur dbt_postgres et connexion avec psql dans l’environnement virtuel de dbt
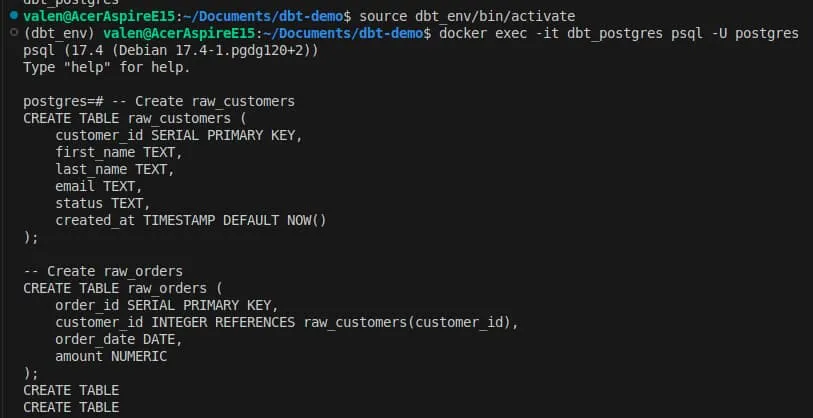
Maintenant, on va créer deux tables dummies à l’intérieur de notre conteneur pour pouvoir créer quelques transformations dans DBT. Copiez et collez le code suivant dans le terminal.
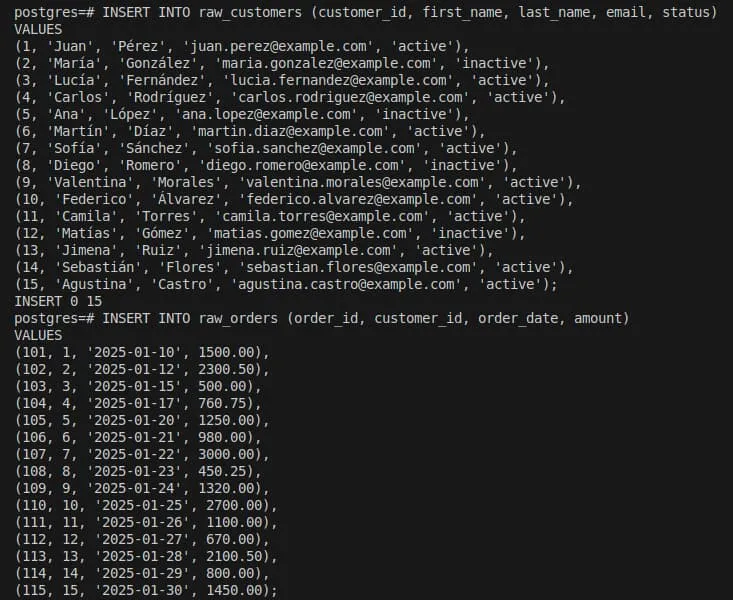
Maintenant on va ajouter des données dummy. Voici les données de raw_customers :
Et voici les données de raw_orders :
Ensuite, vous pouvez lancer cette requête pour vérifier les contenus des tables qu’on a créées :
Maintenant on va définir et configurer nos nouvelles sources. À l’intérieur du dossier de modèles (my_project/models/), on va créer un YAML qu’on appellera src_raw_data.yml. Dedans, on va coller le contenu suivant :
Ici on a déjà définies comme sources de notre projet les deux tables qu’on a créées, et en plus on configure quelques tests (unicité et non-nullité des ID). Étape suivante, on va actualiser notre fichier dbt_project.yml pour inclure l’information du nouveau modèle. Mettons ce code :
Ici on a réglé les configurations de nos modèles dans le fichier général du projet, et on a défini notre stratégie de matérialisation comme « view ». Maintenant on peut enfin créer notre modèle intermédiaire ! À l’intérieur du dossier /models, on va initialiser un nouveau fichier .sql et coller le code SQL suivant.
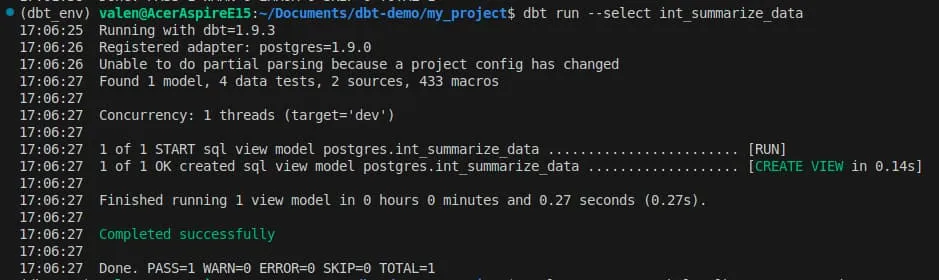
Voilà un modèle exactement comme celui qu’on a vu au début de l’article. Ce qu’il fait c’est prendre nos deux sources, leur assigner un alias, et les unir en utilisant notre customer_id. Maintenant, pour le lancer, exécutez la commande suivante :
dbt run –select int_summarize_data
Si vous avez tout fait correctement, vous devriez voir quelque chose de similaire à ceci :
Si vous voulez voir le code compilé, vous pouvez lancer ceci :
dbt compile –select int_summarize_data
Et si on veut voir le résultat de ce qui s’est matérialisé comme vue, on peut le faire avec cette ligne de code :
psql -U postgres -h localhost -p 5432 -d postgres -c “SELECT * FROM postgres.int_summarize_data LIMIT 10;”
Cela va nous demander le mot de passe qu’on a défini la fois passée dans le fichier profiles.yml. Le résultat devrait être celui-ci :
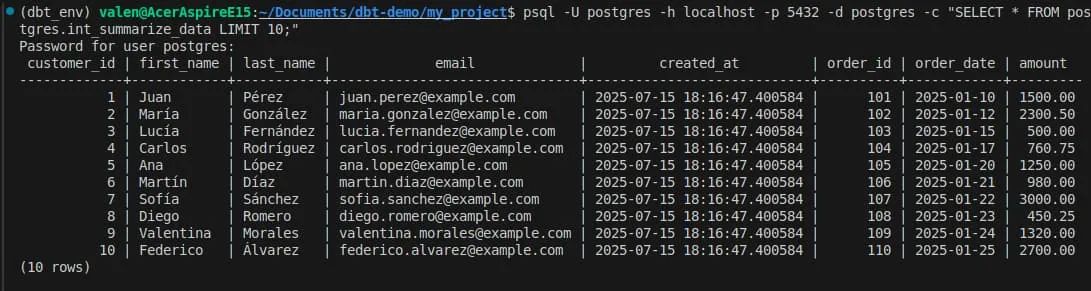
Voilà ! Avec ça, on a déjà lancé notre premier modèle custom de DBT, et on a uni les données des deux tables en utilisant le customer_id comme clé commune. Maintenant on peut visualiser le nom, prénom, mail, date de création, numéro de commande, date de commande et montant de commande pour chacun de nos clients.
Pour clôturer notre démo d’aujourd’hui, on va créer un seed et l’utiliser pour classifier nos ventes selon leur taille. Vous pouvez trouver le CSV avec l’information ici et le télécharger directement (effacez le – Hoja 1 du nom !). Ce fichier contient des catégories de classification des commandes de nos clients et, comme c’est une data statique et brève qui ne changera pas fréquemment, il est approprié de la considérer comme un seed.
Si vous regardez, sous le dossier /models on en a un qui s’appelle seeds. On va laisser notre fichier fraîchement téléchargé là et on va actualiser notre dbt_project.yml avec la configuration de seeds.
Tout cela fait, on peut lancer le seed pour le charger.
dbt seed
Le résultat devrait être quelque chose comme ceci :
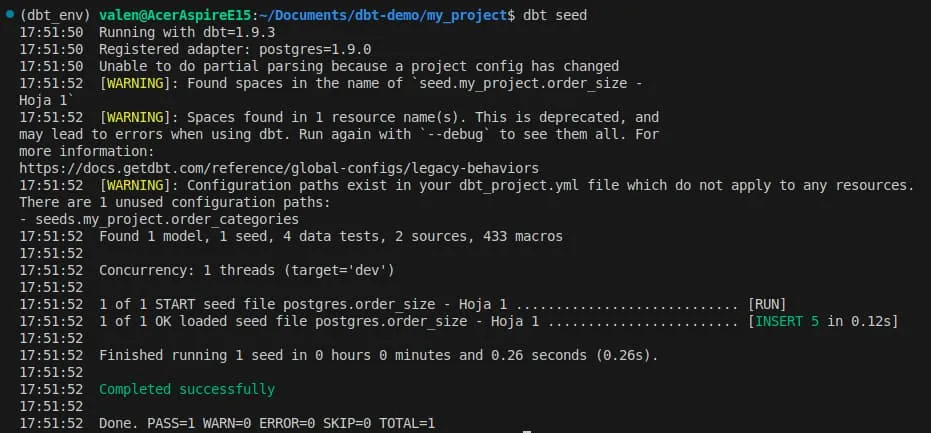
Et après cela, on va créer un nouvel intermédiaire. On va l’appeler int_categorize_orders et ce sera un fichier .sql. Là, on va héberger la requête suivante.
Maintenant, si on lance ce modèle, on va unifier nos transformations.
dbt run –select int_categorize_orders
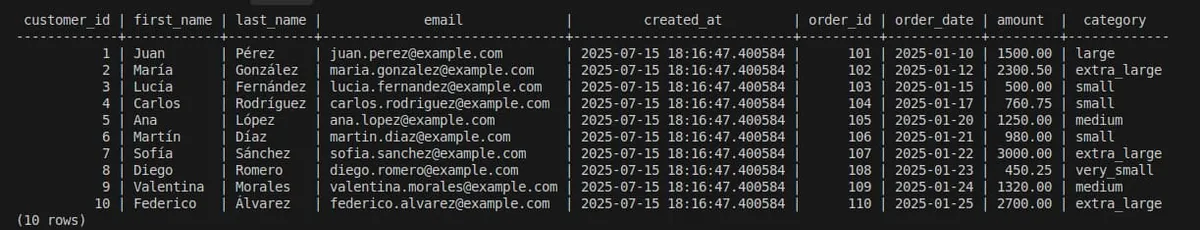
Et si on exécute une requête sur la vue, on verra les résultats.
psql -U postgres -h localhost -p 5432 -d postgres -c “SELECT * FROM postgres.int_categorize_orders LIMIT 10;”
En conclusion…
Ça a été une autre journée de beaucoup d’apprentissage, plein de nouveaux concepts et plein de nouveaux outils dans notre arsenal. Aujourd’hui on a compris en profondeur ce que sont les modèles, comment ils se configurent et comment ils s’exécutent ; on a appris à définir et utiliser des sources pour nos transformations de données ; on s’est familiarisés avec le concept de seeds ; on a compris comment configurer les settings de notre projet ; et même dans la démo on a déjà travaillé avec nos premières transformations enchaînées. Plutôt bien !
Si vous en voulez encore, il y a plus. On fera un nouvel article où on verra comment créer des marts, documenter nos processus et lancer des tests pour garantir l’intégrité de notre data.

