
Une introduction aux outils de Data Quality en Python

Introduction
Récemment, j’ai travaillé sur un projet de Data Engineering visant à construire une architecture de Data Warehouse, en ingérant des données CSV provenant de plusieurs sources. Nous avons eu l’occasion de mettre en place des contrôles de Data Quality dans plusieurs pipelines ETL. Il existe plusieurs outils de qualité des données en Python pour y parvenir.
Dans cet article, je veux passer en revue les concepts fondamentaux de la Data Quality et vous présenter deux de ces outils, Great Expectations et PyDeequ, que nous avons envisagés pour mettre en place ces contrôles. Je vais montrer les avantages et les inconvénients que nous avons observés pour chacun, pour vous aider si c’est la première fois que vous implémentez ce type de fonctionnalité.
Pourquoi la Data Quality ?
Négliger la qualité des données peut entraîner une série de conséquences négatives qui affectent les performances, la réputation et la compétitivité de votre organisation. S’il n’y a pas de données de bonne qualité, les analyses et décisions risquent d’être inexactes. Les parties prenantes pourraient prendre des décisions basées sur des informations obsolètes ou erronées, ce qui pourrait mener à des erreurs potentiellement coûteuses. Il est inévitable que, quand on identifie la source d’erreurs dans les données, la confiance envers les données et les équipes responsables s’érode. De plus, si les données sont partagées en dehors de l’organisation et qu’il y a des problèmes de Data Quality, les utilisateurs peuvent aussi perdre confiance, ce qui nuit à la réputation de l’organisation.
Par ailleurs, travailler avec des données de mauvaise qualité peut mener à des perceptions incorrectes et à une perte de focus sur la vraie valeur de l’information, poussant les équipes data à perdre du temps à chercher la source des erreurs. Vu positivement : assurer la qualité des données signifie que les décisions de votre organisation seront bien informées et à jour, évitant les coûts liés aux mauvaises décisions et améliorant la compétitivité de votre entreprise.
Quels sont les aspects de Data Quality qu’on évalue habituellement ?
-
Exactitude (Accuracy) : L’exactitude des données mesure à quel point les données reflètent les entités du monde réel qu’elles représentent. Des données précises sont exemptes d’erreurs et d’inconsistances.
-
Complétude (Completeness) : La complétude évalue si toutes les données nécessaires sont présentes. Elle garantit qu’aucune information critique ne manque dans les jeux de données.
-
Ponctualité (Timeliness) : La ponctualité fait référence à la fraîcheur des données. Elle mesure à quel point les données sont à jour et si elles respectent les délais requis pour l’analyse et la prise de décision.
-
Unicité (Uniqueness) : L’unicité garantit qu’il n’y a pas d’enregistrements dupliqués dans le jeu de données.
-
Validité (Validity) : La validité vérifie si les données respectent des règles et contraintes prédéfinies ; elle s’assure que les données sont dans le format attendu et respectent les standards de qualité.
-
Cohérence (Consistency) : La cohérence évalue l’uniformité des données à travers différentes sources et systèmes. Des données inconsistantes peuvent mener à des confusions et des inexactitudes.
-
Adéquation à l’usage (Fitness for Purpose) : Les données doivent être adaptées à leur usage prévu. Cela signifie que les données doivent être pertinentes et appropriées pour des taches et analyses spécifiques.
Principales caractéristiques des outils de Data Quality
Voici quelques-unes des caractéristiques clés des outils de Data Quality qui peuvent vous aider à choisir le plus adapté :
-
Validation des données : Un élément essentiel des outils de qualité des données est la capacité de vérifier que certaines “règles” sont respectées dans les données qu’on veut analyser. Cela inclut la vérification que les valeurs des colonnes sont dans des plages spécifiques, qu’il n’y a pas de valeurs nulles dans une colonne, que les valeurs statistiques comme les moyennes et écarts-types sont dans des limites prédéfinies, entre autres validations.
-
Profiling / Suggestion automatique de règles de validation : Une autre caractéristique importante est la capacité de réaliser une analyse automatique d’un échantillon des données qu’on veut traiter. Cela permet d’extraire les caractéristiques générales des données, d’identifier les plages dans lesquelles se trouvent les variables, de déterminer les types de variables, de détecter les valeurs manquantes et d’identifier les patterns de distribution. Sur la base de cette information (profilage), les outils peuvent suggérer des validations de Data Quality et des règles applicables.
-
Détection d’anomalies : En se basant sur le profil ou le comportement des colonnes de notre dataset, ces outils peuvent proposer des alertes qui détectent si une métrique liée aux données, comme la moyenne ou l’écart-type, sort de limites prédéfinies et s’écarte significativement de ce qui est attendu. Cette fonction est essentielle pour identifier des données atypiques qui pourraient indiquer des problèmes de qualité ou des problèmes dans le processus d’acquisition des données.
-
Génération de rapports : Certains outils de Data Quality peuvent générer des visualisations interactives, des rapports détaillés ou des résumés exécutifs qui synthétisent les résultats de l’analyse du dataset et des validations appliquées. Ces rapports aident les utilisateurs à comprendre la qualité des données et les conclusions clés de manière claire et concise, facilitant la prise de décisions éclairées et la communication des résultats aux parties prenantes.
-
Récupération des enregistrements échoués : En cas de non-respect des validations, certains outils de Data Quality permettent aux développeurs d’identifier les enregistrements spécifiques contenant des erreurs, qui peuvent être marqués et priorisés pour examen et action. Cela aide à maintenir l’intégrité des données et garantit que les problèmes sont traités en temps voulu.
-
Intégrations : Beaucoup d’outils de Data Quality offrent diverses options pour se connecter à d’autres sources de données, systèmes d’orchestration ou pour envoyer les résultats vers différentes destinations. Ces intégrations facilitent l’automatisation du workflow, l’incorporation de données externes et la distribution efficace des résultats d’analyse à travers différents canaux et systèmes, améliorant l’efficacité des opérations liées à la qualité des données.
PyDeequ
Description
PyDeequ est une bibliothèque de validation de données originellement conçue en Scala puis adaptée pour Python. Cet outil fournit des capacités de détection d’anomalies, profiling et suggestion de contrôles de Data Quality. PyDeequ s’intègre à l’écosystème Spark, ce qui permet la gestion efficace de datasets de grande taille.
Dans PyDeequ, la fonctionnalité de suggestion de règles (constraint suggestion) permet d’analyser un échantillon des données pour obtenir rapidement des conditions de Data Quality qui seront appliquées à chaque colonne. Ces contraintes peuvent ensuite être copiées et incorporées dans un ensemble de vérifications chaînées pour les utiliser sur le reste des données à traiter. Les constraints permettent aussi de spécifier un seuil en pourcentage auquel une erreur ou un avertissement doit être déclenché via des fonctions lambda. On peut aussi spécifier des indices ou hints pour identifier rapidement les constraints lors de la restitution des résultats.
De plus, PyDeequ fournit plusieurs analyseurs qui servent de mesures de caractéristiques spécifiques du dataset, comme la taille du dataset, l’écart-type, le pourcentage de valeurs uniques, le matching de patterns définis par des expressions régulières, etc. Ces analyseurs peuvent être utilisés pour détecter des anomalies basées sur un dataset de référence en établissant des seuils. Si les valeurs de l’analyseur varient entre datasets au-delà d’une certaine proportion définie par les seuils, ce phénomène est signalé.
Guide de démarrage rapide
- Générez un dataset d’exemple (vous pouvez exécuter ce code dans le répertoire de travail et les données seront générées dans Example_Data/Batches/Example_batch0.csv) :
from faker import Faker
import pandas as pd
import random

fake = Faker(seed=123)

num_rows = 1000

data = {
    "Name": [fake.name() for _ in range(num_rows)],
    "Email": [fake.email() for _ in range(num_rows)],
    "Phone": [fake.phone_number() for _ in range(num_rows)],
    "Address": [fake.address() for _ in range(num_rows)],
    "Date of Birth": [fake.date_of_birth(minimum_age=18, maximum_age=80).strftime("%Y-%m-%d") for _ in range(num_rows)],
    "Salary": [fake.random_int(min=30000, max=100000) for _ in range(num_rows)],
    "Department": [fake.random_element(elements=("HR", "IT", "Finance", "Sales", "Marketing")) for _ in range(num_rows)],
    "Hire Date": [fake.date_this_century().strftime("%Y-%m-%d") for _ in range(num_rows)],
    "Employee ID": [fake.unique.random_number() for _ in range(num_rows)],
    "Vacation_Days": [fake.random_int(min=0, max=30) if random.random() > 0.1 else None for _ in range(num_rows)]
}

# Introduce null values in some columns
for i in range(100):
    data["Email"][random.randint(0, num_rows - 1)] = None
    data["Salary"][random.randint(0, num_rows - 1)] = None

# Replace some values in the "Department" column with rare values
for i in range(50):
    data["Department"][random.randint(0, num_rows - 1)] = fake.random_element(
        elements=("Legal", "R&D", "Customer Support")
    )

df = pd.DataFrame(data) # Create a DataFrame from the generated data

output_folder = "Example_Data/Batches/"
os.makedirs(output_folder, exist_ok=True)

split_dfs = np.array_split(df, 3)  # Split the DataFrame

for i, split_df in enumerate(split_dfs):
    file_name = f"{output_folder}Example_batch{i}.csv"
split_df.to_csv(file_name, sep=",", index=False)- Chargez le dataset d’exemple et créez une session Spark.
import pandas as pd
from pyspark.sql import SparkSession
import sagemaker_pyspark
import pydeequ

df = pd.read_csv('Example_Data/Batches/Example_batch0.csv')

classpath = ":".join(sagemaker_pyspark.classpath_jars())

spark = (SparkSession.builder
	.config("spark.driver.extraClassPath", classpath)
	.config("spark.jars.packages", pydeequ.deequ_maven_coord)
	.config("spark.jars.excludes", pydeequ.f2j_maven_coord)
	.getOrCreate()
)- Lancez la commande qui suggère les constraints.
from pydeequ.suggestions import *

suggestionResult = ConstraintSuggestionRunner(spark) \
	.onData(df) \
	.addConstraintRule(DEFAULT()) \
.run()- Vous pouvez afficher les constraints suggérés :
for sugg in suggestionResult['constraint_suggestions']:
	print(f"Constraint suggestion for '{sugg['column_name']}': {sugg['description']}")

for sugg in suggestionResult['constraint_suggestions']:
print(f"{sugg['code_for_constraint']}")- Chargez un nouveau batch de données :
df = pd.read_csv('Example_Data/Batches/Example_batch1.csv')
df.columns- Créez un check :
from pydeequ.checks import *
from pydeequ.verification import *

check = Check(spark, CheckLevel.Error, "Integrity checks")- Ajoutez les constraints suggérés au check, formant une “vérification suite”, et exécutez :
checkResult = VerificationSuite(spark) \
.onData(df) \
.addCheck(
check.hasSize(lambda x: x <= 300_000) \
	.isContainedIn("Department", ["Marketing", "HR", "Finance", "IT", "Sales"])
	.isComplete("Department")
	.isComplete("Name")
	.isUnique("Name")
	.isComplete("Address")
	.isUnique("Address")
	.isComplete("Hire_Date")
	.isUnique("Hire_Date")
	.isComplete("Vacation_Days")
	.isNonNegative("Vacation_Days")
	.isComplete("Date_of_Birth")
	.isComplete("Email")
	.isUnique("Email")
	.isComplete("Phone")
	.isComplete("Salary")
	.isNonNegative("Salary")
	.isComplete("Employee_ID")
	.isNonNegative("Employee_ID")
	.isUnique("Employee_ID")
).run()- Convertissez les résultats en dataframe Pandas et affichez-les :
checkResult_df = VerificationResult.checkResultsAsDataFrame(spark, checkResult)
checkResult_df.toPandas().head(10)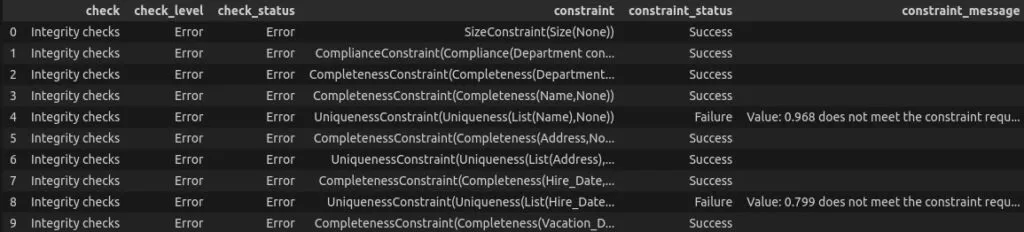
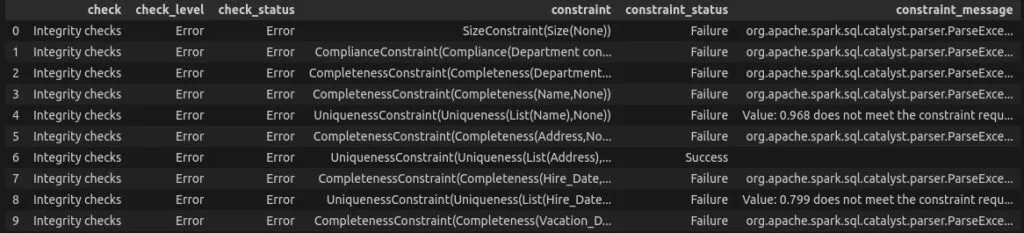
Attention à ne pas utiliser d’espaces dans les noms de colonnes ni à avoir des fautes de frappe, car cela peut générer des messages d’erreur dans de nombreuses conditions. Montrons cette erreur en exécutant à nouveau la “vérification suite”, mais en supprimant le tiret bas de “Employee_ID” dans la ligne qui contient le check .isNonNegative(“Employee_ID”). Le résultat est :
Commentaires supplémentaires :
-
Une caractéristique unique de PyDeequ est le constraint “satisfies”, qui permet de définir des conditions en langage SQL pour les colonnes. C’est particulièrement utile pour valider que les données respectent des conditions logiques composées de plusieurs conditions plus simples.
-
Il est important de noter que, contrairement à certains autres outils, PyDeequ ne génère pas de rapports ; il livre les résultats dans un dataframe, et c’est à l’utilisateur d’implémenter la fonctionnalité pour accéder aux données et les incorporer dans un rapport.
Great Expectations
Description :
Great Expectations est un outil open source base sur Python qui bénéficie du soutien d’une grande communauté. Ce projet s’est intégré avec succès à une large variété de sources et d’outils de données, ce qui en fait un choix polyvalent pour la gestion de la Data Quality.
Dans Great Expectations, les règles de Data Quality sont structurées comme des “expectations”. Ces expectations sont définies “de manière positive”, ce qui signifie qu’elles spécifient les conditions que les données doivent remplir. Si les données ne respectent pas ces conditions, l’expectation renvoie une alerte, signalant un problème potentiel de Data Quality.
Cette approche permet aux professionnels de la data d’articuler et de faire respecter les exigences de qualité des données de manière claire et pratique. Par exemple, on peut établir des expectations indiquant que les colonnes de données doivent respecter des types de données spécifiques, des plages ou des contraintes de valeurs. Si les données s’écartent de ces attentes, Great Expectations générera les alertes correspondantes.
De plus, Great Expectations offre d’autres fonctionnalités incluant le profiling de données, la validation automatique, le monitoring continu et l’intégration avec diverses plateformes de données. Il se distingue notamment en fournissant une bonne documentation des données, offrant des informations précieuses sur les distributions de données et les statistiques résumées. Cette documentation améliore non seulement la transparence des données, mais facilite aussi la collaboration entre équipes data.
Bien que Great Expectations offre de nombreux avantages, les utilisateurs doivent garder un oeil attentif sur sa documentation, car les mises à jour fréquentes peuvent générer des changements et variations entre versions. De plus, exprimer des conditions logiques complexes directement via des expectations peut devenir assez complexe. Cependant, l’outil offre la flexibilité de travailler avec des “row conditions” pour gérer une logique plus elaborate.
Voyons quelques commandes pour comprendre les fonctionnalités clés de cet outil.
Guide de démarrage rapide
Pour commencer, dans un environnement Conda avec Python, vous pouvez installer Great Expectations avec pip :
pip install great_expectations
pip install great_expectations_experimental
Personnellement, je recommande de commencer en utilisant l’interface en ligne de commande (CLI) de Great Expectations pour effectuer les configurations initiales de notre projet. Cet outil nous guide pas à pas dans la définition des sources de données et des validations qu’on veut effectuer, et crée automatiquement des notebooks avec le code nécessaire pour les implémenter. Avec ce code, on peut ensuite faire des modifications pour déterminer complètement les opérations et obtenir les résultats de validation dans le format attendu.
Pour développer un projet avec la CLI, il faut créer un répertoire vide et activer l’environnement Conda où Great Expectations a été installé. À partir de là, utiliser les commandes suivantes.
great_expectations init
great_expectations init crée une structure de répertoires pour Great Expectations, où seront stockés les sources de données (datasources) qui pointent vers les données qu’on veut traiter, les règles de validation qui seront appliquées, les notebooks générés par l’assistant et les rapports HTML résultant des analyses.
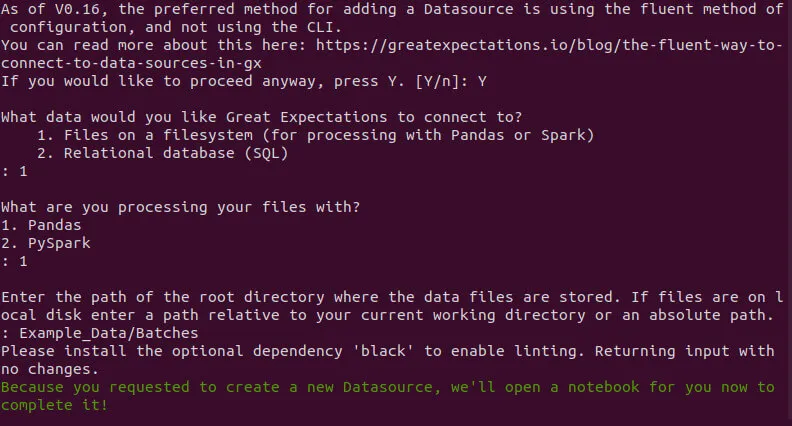
Ensuite, en exécutant great_expectations datasource new, on spécifie d’où proviendra le dataset à traiter. Parmi les options, on peut choisir File System et un serveur SQL. Si on sélectionne File System, il faut déterminer si le moteur utilisé est Spark ou Pandas et spécifier le répertoire où se trouvent les fichiers à traiter (tout cela est montré dans l’image ci-dessous).
Une fois les étapes précédentes confirmées, l’assistant ouvrira un notebook Jupyter qui doit être exécuté entièrement pour que les configurations s’appliquent au projet. Le notebook se trouve dans le répertoire du projet et on peut choisir de le supprimer ou de le garder pour effectuer des modifications de configuration ultérieurement.
Dans le notebook Jupyter, il faut vérifier le string yaml de la configuration du Datasource. Dans le champ “data_connectors”, les premières lignes devraient contenir des informations comme :
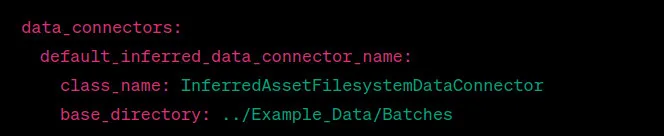
La commande suivante est great_expectations suite new, avec laquelle on crée une nouvelle suite d’expectations. L’assistant propose 3 options :
-
Créer la suite manuellement
-
Créer la suite à partir d’un data asset
-
Créer la suite avec l’assistant.
Si c’est la première fois que vous utilisez Great Expectations, on recommande l’option 3, car les 2 premières nécessitent une connaissance des expectations disponibles et une expertise métier pour déterminer quelles validations sont nécessaires pour nos données. Si vous avez sélectionné l’option 3, vous pouvez choisir un fichier dans le répertoire de données configuré précédemment, pour inférer le schéma des tables et les validations qui pourraient s’appliquer.
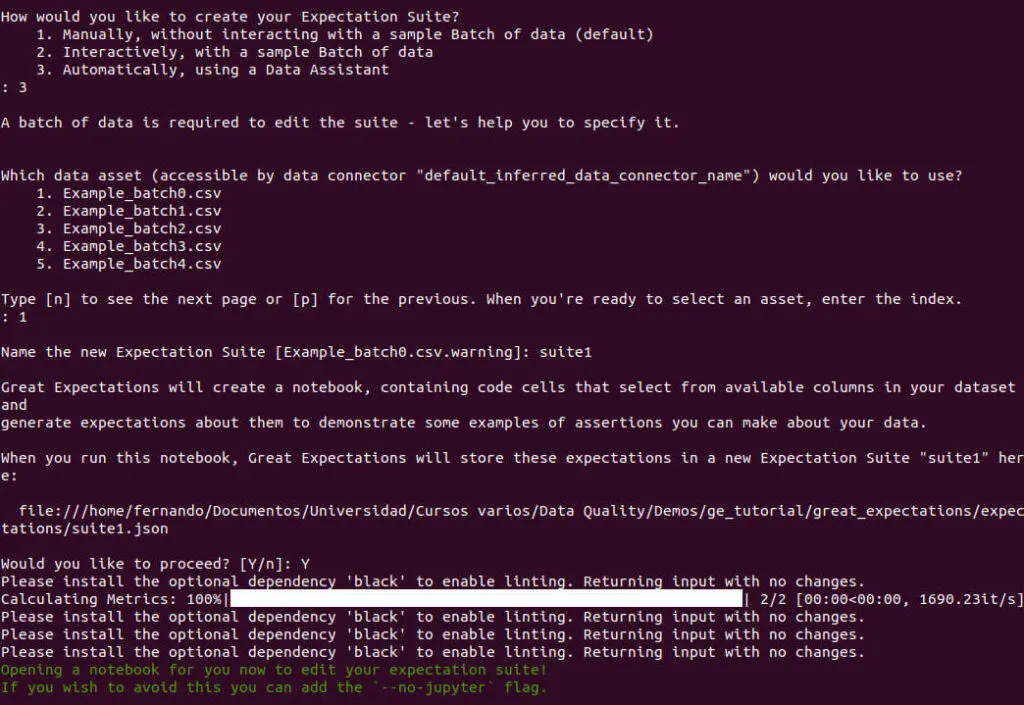
Quand vous sélectionnez le fichier choisi pour inférer le schéma, on vous demandera d’attribuer un nom à la nouvelle suite et de confirmer la sélection finale. Après cela, un notebook s’ouvre qu’il faut exécuter pour que Great Expectations suggère les expectations applicables au dataset spécifié. Il faut exécuter toutes les cellules du notebook, et un nouvel onglet s’ouvrira dans le navigateur avec un rapport HTML décrivant les expectations générées pour la suite.
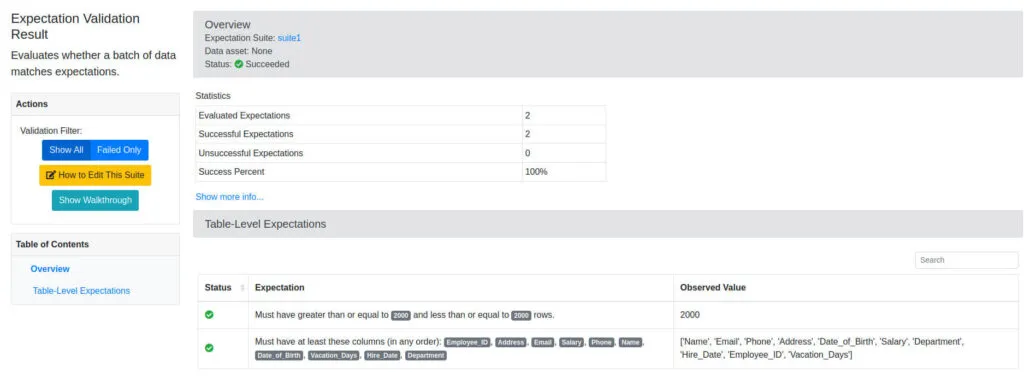
Ces expectations se trouvent dans le répertoire du projet dans great_expectations/expectations/<nom_de_la_suite>.json. On peut modifier ce fichier en ajoutant ou supprimant des expectations. Le catalogue des expectations disponibles, ainsi que leur état de développement, se trouve sur https://greatexpectations.io/expectations/.
Exécuter great_expectations checkpoint new <nom_du_checkpoint> ouvre un notebook qui permet de configurer le checkpoint. Dans ce notebook, de nombreuses configurations sont listées basées sur le datasource et la suite d’expectations configurées aux étapes précédentes. Il permet aussi d’établir des configurations supplémentaires. Par exemple, on peut choisir un fichier différent de l’original sur lequel appliquer les expectations. De plus, avec du code supplémentaire, on peut spécifier que les expectations s’appliquent à plusieurs fichiers dont les noms correspondent à une certaine expression régulière (multi-batch request).
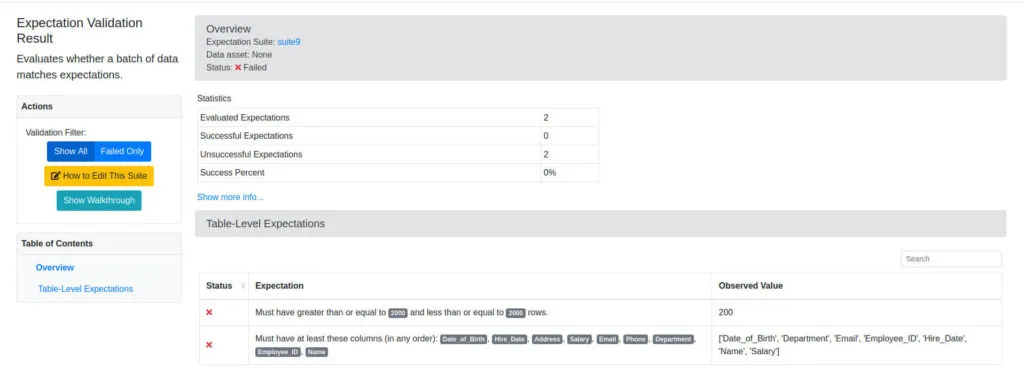
La dernière cellule du notebook contient des lignes de code commentées qui, une fois exécutées, appliquent le checkpoint et affichent les résultats dans un rapport HTML dans un nouvel onglet du navigateur. Si on utilise un batch de données sans une des colonnes et avec des lignes manquantes, on devrait voir un rapport comme celui montré ci-dessous :
Les checkpoints créés restent dans le répertoire du projet dans :
great_expectations/checkpoints/<nom_du_checkpoint>.yml
Les résultats des checkpoints se trouvent dans le répertoire du projet au format JSON dans :
great_expectations/uncommitted/validations/<nom_de_la_suite>/<time_stamp>/<time_stamp>/<random_hash_name>.jsonou bien comme rapports au format HTML dans :
great_expectations/uncommitted/data_docs/local_site/validations/<nom_de_la_suite>/<time_stamp>/<time_stamp>/<random_hash_name>.HTMLEnfin, avec great_expectations checkpoint run <nom_du_checkpoint> on peut appliquer le checkpoint via la CLI.
Commentaires supplémentaires :
-
On recommande de regarder le workflow de multi-batch requests.
-
Parmi les intégrations disponibles dans Great Expectations, voici celles qu’on souhaite souligner :
Conclusion
Dans cet article, on a pu voir les fondamentaux de la qualité des données et présenter deux outils bases sur Python pour réaliser des analyses dans ce domaine. PyDeequ adopte une approche un peu plus simple et directe pour appliquer des contrôles, tandis que Great Expectations offre des fonctionnalités très utiles pour des projets de plus grande envergure. Si vous voulez en savoir plus sur ces outils, laissez vos questions en commentaires.


