
Comment appliquer le Feature Selection dans votre projet de Data Science

Le feature selection est une technique de feature engineering qu’on utilise pour sélectionner les caractéristiques les plus pertinentes pour un modèle de machine learning.
Avant d’entrer dans le vif du sujet, il faut préciser que le feature engineering, c’est le processus de préparation des données pour la modélisation. Ça inclut la sélection, la création et la transformation des caractéristiques qu’on va utiliser dans le modèle. Le feature selection, lui, désigne spécifiquement la sélection de ces caractéristiques.
Pourquoi le feature selection est-il important ?
Souvent, on a beaucoup de caractéristiques disponibles pour un problème donné, mais elles ne sont pas toutes nécessaires ou pertinentes pour le modèle.
Utiliser toutes les caractéristiques disponibles peut rendre le modèle moins précis, voire plus lent à l’exécution.
En plus, utiliser des caractéristiques non pertinentes ou redondantes peut dégrader les performances du modèle.
Comment choisir les caractéristiques les plus pertinentes pour notre modèle ?
Il existe plusieurs techniques, et le choix dépend du jeu de données et du type de modèle qu’on construit.
Voici quelques techniques courantes :
Filtrage
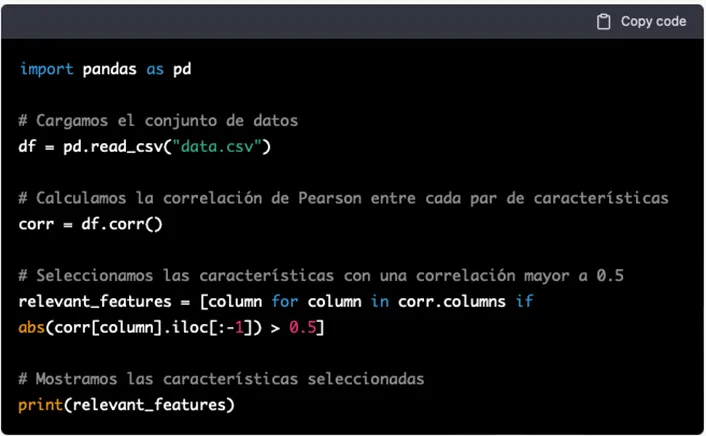
Cette technique s’appuie sur des mesures statistiques pour sélectionner les caractéristiques les plus pertinentes. Par exemple, on pourrait utiliser la corrélation de Pearson pour sélectionner les caractéristiques les plus corrélées avec la variable cible.
Voici un exemple d’utilisation de la corrélation de Pearson en Python :
Wrapper
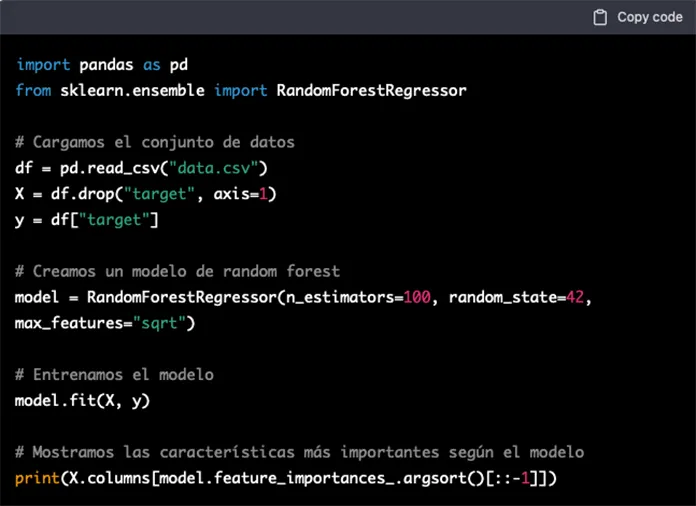
Cette technique utilise le modèle de machine learning comme un “emballage” pour sélectionner les caractéristiques. Par exemple, on pourrait utiliser un modèle de régression linéaire et éliminer les caractéristiques une par une.
Voici un exemple d’utilisation de la technique wrapper en Python :
Embedded
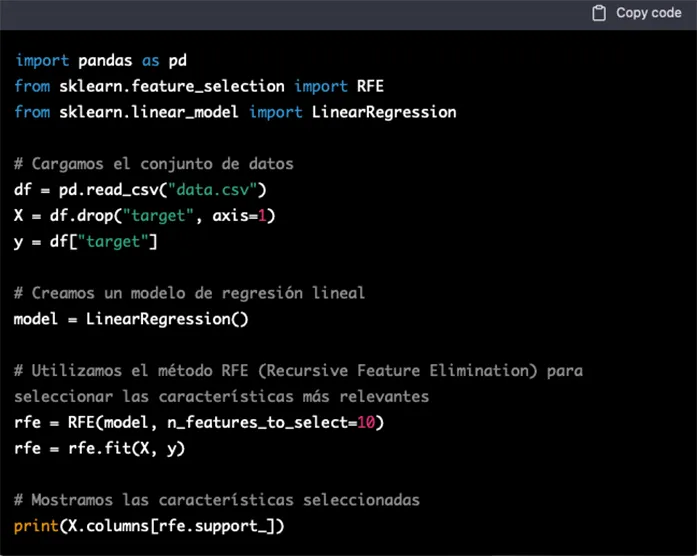
Cette technique intègre la sélection des caractéristiques dans le processus d’entraînement du modèle. Par exemple, certains algorithmes d’arbres de décision incluent une fonction de sélection automatique des caractéristiques.
Voici un exemple d’utilisation de la technique embedded en Python :
N’oubliez pas que le feature selection est une étape clé du processus de modélisation en machine learning : il nous aide à améliorer la précision et la performance de nos modèles en éliminant les caractéristiques non pertinentes ou redondantes.
Pour finir, une réflexion : on est parfois tentés d’utiliser toutes les caractéristiques disponibles en se disant que plus, c’est mieux. Mais comme on l’a vu, utiliser des caractéristiques non pertinentes ou redondantes peut nuire à la performance du modèle.
C’est pour ça que le feature selection est essentiel pour construire des modèles plus précis et robustes. Alors prenons le temps et l’énergie d’y travailler pendant la phase de modélisation.

