Blog
Ideas y opiniones sobre datos, IA y tecnología aplicada.
¿Cuánto cuesta un proyecto de datos con una consultora? Variables, rangos y lo que nadie te dice
Nadie en la industria habla de precios. En este artículo desglosamos las cinco variables que afectan el costo de un proyecto de datos en un entorno productivo para generar transparencia total respecto del costo de la inversión.
La diferencia entre una PoC y un MVP (y por qué confundirlos te sale caro)
La mayoría de proyectos de IA fracasan porque no hay una conversación clara sobre si necesitás probar que algo se puede hacer o que efectivamente funcione en producción. Acá contamos cómo evitar ese error.
Por qué la mayoría de los proyectos de IA no llegan a nada
Hay cuatro errores que aparecen una y otra vez en proyectos de IA que quedan en la nada: buscar respuestas sin preguntas, dejar desamparado al equipo interno, no definir el éxito y confundir diagnóstico con ejecución. Los que funcionan, saben cómo sortear estos obstáculos.
DBT en acción: construí la capa de marts que conecta tus datos con el negocio
Los marts son la capa donde tus modelos de DBT se vuelven realmente útiles: datasets curados, listos para análisis y decisiones de negocio.
Cómo usar contenedores custom en SageMaker para inferencia con LightGBM (guía paso a paso)
Guía completa para correr inferencias batch con LightGBM en AWS SageMaker: aprende cómo desplegar procesamiento masivo, reproducible y escalable usando contenedores e IA predictiva.
Vibe coding con IA: 10 buenas prácticas para codear rápido (sin perder el control)
Vibe coding no es delegar todo a la IA: es programar asistido con criterio. En esta guía te mostramos 10 prácticas para documentar en lenguaje natural, generar tests, aplicar cambios incrementales, modularizar, elegir herramientas y versionar sin drama.
Modelos, Sources y Seeds en dbt: Tutorial completo para transformar datos con SQL reproducible
Domina dbt con esta guía práctica: aprende a crear modelos, declarar sources y gestionar seeds usando Docker y Postgres. Tutorial paso a paso para acelerar tu modern data stack y lograr transformaciones de datos reproducibles y confiables.
Petróleo & gas 4.0: las claves del sector para aplicar IA
La transformación digital en petróleo y gas anuncia mejoras en eficiencia, seguridad y costos, pero la cultura corporativa puede frenar el avance. Resistencia al cambio, brechas de talento digital y jerarquías rígidas hacen que el 70% de los proyectos se estanquen.
Cómo sumar IA generativa local a Grafana y convertir gráficos en decisiones
Integrá un modelo de lenguaje local (LLM) en Grafana y convertí tus dashboards en herramientas inteligentes para la toma de decisiones. En esta guía paso a paso te mostramos cómo visualizar, analizar e interpretar métricas en tiempo real sin exponer datos a servicios externos.
IA y Recursos Humanos: 6 formas de automatizar y potenciar tu empresa
La inteligencia artificial generativa (GenAI) está revolucionando el área de Recursos Humanos. Este artículo explora cómo la IA aplicada puede optimizar seis procesos clave: adquisición de talento, relación con empleados, capacitación, gestión del desempeño, administración y compliance.
Codear con type hints: una práctica simple que optimiza tu negocio
Descubrí cómo el uso de type hints en Python y herramientas como MyPy pueden ayudarte a escribir mejor código, evitar errores y mejorar la eficiencia de tu equipo de desarrollo. Buenas prácticas simples, con impacto real en tu negocio.
La verdad incómoda sobre la IA: ¿y si no es para tu negocio?
Muchas empresas sienten que deben aplicar inteligencia artificial, pero no siempre es la mejor decisión. En esta nota te ayudamos a identificar si tu negocio está realmente listo para aprovechar la IA, cómo evitar inversiones mal enfocadas y por qué la estrategia de datos sigue siendo el verdadero diferencial.
Modernizá tu stack de datos con DBT: menos deuda técnica, más velocidad para decidir
DBT optimiza tus procesos de datos para generar insights más rápidos, reducir la deuda técnica y mejorar el retorno de inversión en analítica.
Ciencia de datos y petróleo: Una oportunidad única para Argentina
En el contexto argentino, el sector oil & gas presenta una oportunidad estratégica única. Descubrí cómo implementar soluciones de ciencia de datos para impulsar la eficiencia y rentabilidad.
Discovery de Machine Learning: 4 semanas para decidir cómo aplicar ML en tu negocio
En Deployr diseñamos un proceso de Discovery en 4 semanas para validar si machine learning es la solución correcta para tu problema de negocio. Te contamos cómo funciona y por qué es clave antes de invertir en un proyecto de ML.
Una introducción a herramientas de Data Quality en Python
Guía completa sobre Great Expectations y PyDeequ: herramientas de calidad de datos en Python para pipelines de ETL robustos y confiables.
Entrá al mundo serverless creando un scraper automático de Twitter en AWS en cinco sencillos pasos
Tutorial paso a paso para crear un scraper serverless con Lambda, EventBridge y S3: aprende a automatizar extracciones de datos sin gestionar servidores.
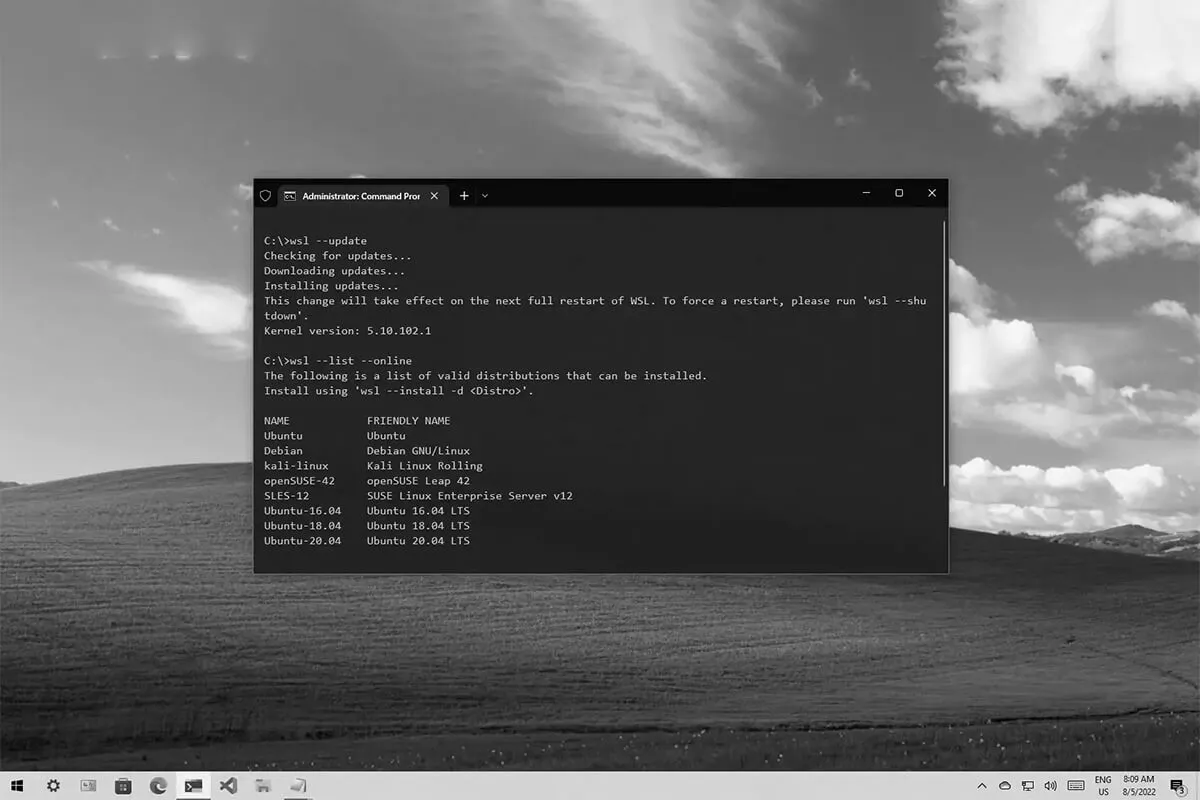
WSL: Cómo instalar Linux dentro de Windows (lo mejor de ambos mundos)
El Windows Subsystem for Linux (WSL) permite a los desarrolladores usar un entorno GNU/Linux directamente sobre Windows. Es una alternativa simple y eficiente al dual boot.
Roles, permisos, identidades y grupos: ¿Cómo usar AWS de forma segura y sin miedo a equivocarnos?
Guía completa para entender y configurar el control de accesos en AWS: aprende a crear usuarios, grupos, roles y políticas de seguridad de forma prolija y escalable.
Cómo Aplicar Feature Selection en tu proyecto de Ciencia de Datos
Aprendé todo acerca de feature selection, una técnica de feature engineering que se utiliza para seleccionar las características más relevantes para un modelo de machine learning.
¿Qué le duele a tu organización?
No vendemos tecnología genérica. Hablemos de lo que necesitás resolver.
Hablemos